WebGPUの学習の一環で、Particle Lifeを作成しました。
シミュレーション部分をComputeShaderで計算しています。
WebGPU Particle Life
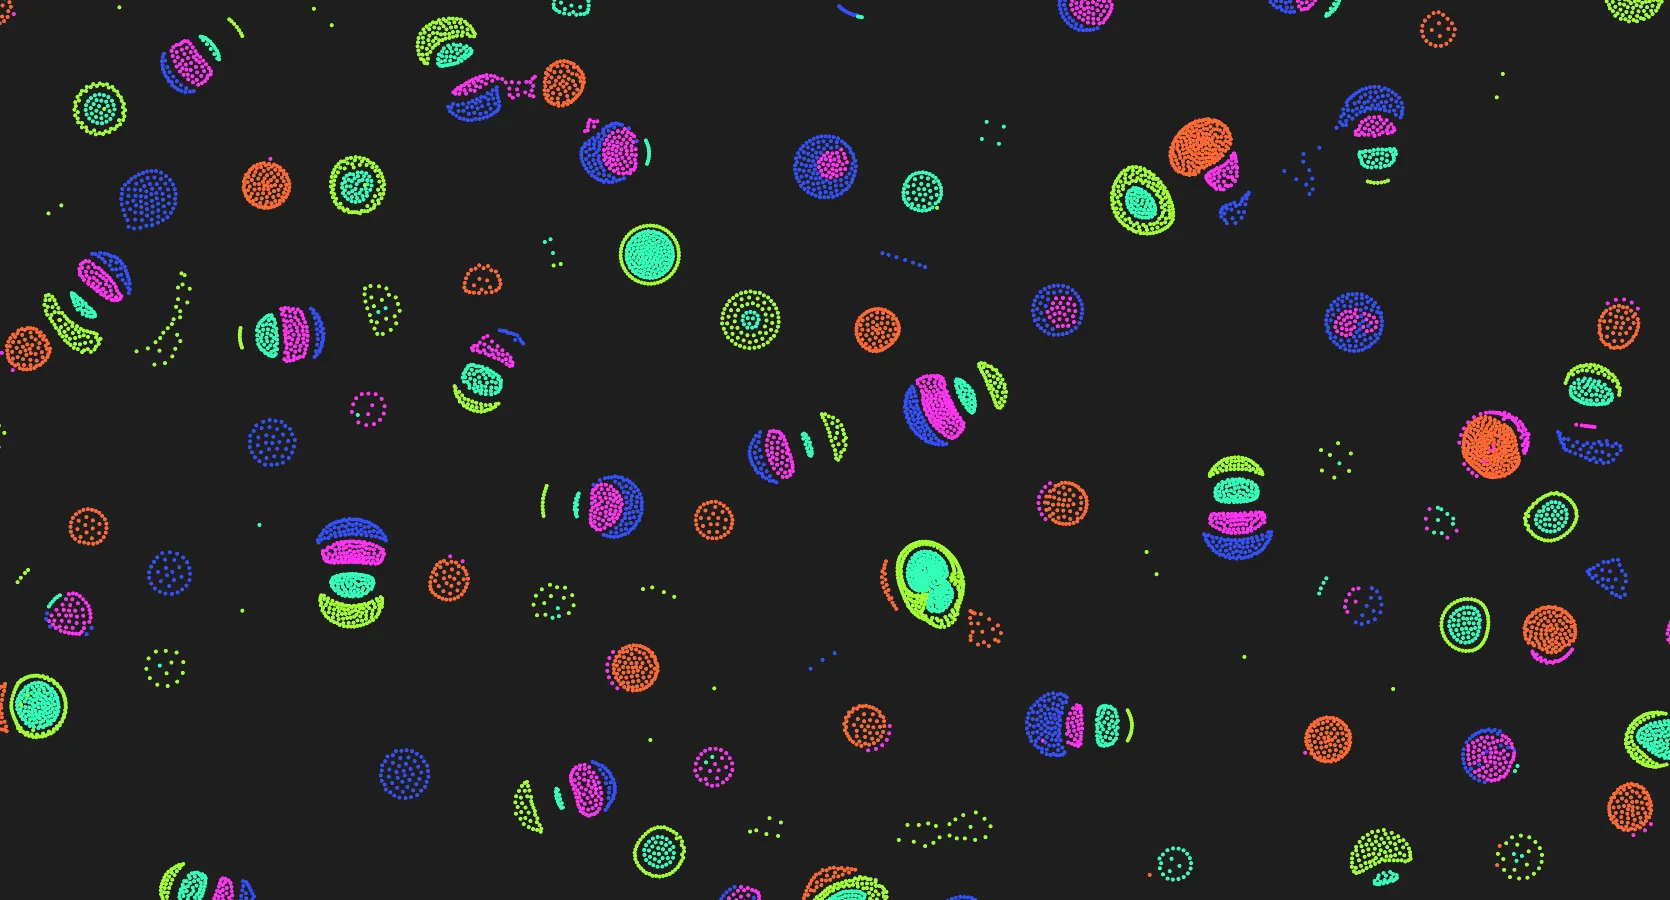
spoon-inoue.github.io/webgpu-particle-life/
概要
GPU(Shader)を使うと大量のParticleの位置を並列計算でき、CPU(JavaScript)で計算を行うよりはるかに多くのParticleを扱えるようになります。
今回の題材のようなParticle Simulationでは、着目しているParticleからある半径内に含まれるParticleからの作用を受けて、速度・位置が更新されます。
そのため、Shaderを使ったとしても並列計算の中でParticleの数だけループ処理を書き、距離を比較する必要があります。
並列計算させているとはいえ、Particleの数が多くなるほどパフォーマンスが下がります。
そこで、WebGPU(WGSL)の機能を使って、Uniform GridとCounting Sortを組み合わせた最適化を試してみました。
Particle Simulationとは、大量の細かい「粒子(パーティクル)」を基本単位として使い、物理法則や力学計算に基づいてその動きや振る舞いをコンピュータ上で再現・予測する技術です。
その中でも自身とその周囲のParticleが相互作用するタイプのParticle Simulationには、以下のようなものがあります。
- Boids
- Particle Life
- SPH (Smoothed Particle Hydrodynamics)
実装方針
Particle Loop
単純にComputeShader内でPaticle分のループ処理を書く場合を考えます。
画面上に無数のParticleがあり、赤点に着目しているとします。
赤点が受ける作用は、赤点からある半径の範囲(rMax)内のParticleに限られます。
そのため、全Particleと赤点との距離とrMaxを比較する必要があります。
for(var i = 0u: i < arrayLength(&readParticles); i++) {
  let other = readParticles[i];
  let vOtherSelf = other - self;
  let rMax2 = rMax * rMax;

  if (dot(vOtherSelf, vOtherSelf) < rMax2) {
    // 範囲内
  }
}
実際に作用を及ぼすrMax範囲内のParticleは、全体のごくわずかであることがわかります。
Uniform Grid
着目している赤点の周りのParticleのみを比較対象にして、無駄なループ回数を減らすために、下図のようなGrid分割を考えます。
1つのセルの大きさはrMax以上になるため、赤点の周囲9セルに含まれたParticleのみループで取得できれば、rMax内のParticleを効率よく参照できます。
CanvasサイズがWindowサイズと一致しているとき、Gridのマス目(Cell)の大きさは以下のように求まります。
const row = Math.floor(window.innerHeight / rMax);
const col = Math.floor(window.innerWidth / rMax);すべてのセルの間隔が均等(同じ大きさ)に整えられた格子状のグリッドのことをUniform Gridと言います。
Shaderでの比較処理は以下のようになります。
let cellId = i32(particleCell[i]);
let cell = vec2i(
  cellId % grid.x,
  cellId / grid.x,
);

for (var x = -1; x <= 1; x++) {
  for (var y = -1; y <= 1; y++) {
    let nx = cell.x + x;
    let ny = cell.y + y;
    let neighborCellId = u32(ny * grid.x + nx);

    for() {
      // neighborCellIdのcellに含まれるparticleのループ処理
      //...
    }
  }
}
particleCellは、Particleが所属するcellのidを格納したBufferです。
neighborCellIdのcellに含まれるParticle(着目している赤点の近辺のcellに含まれるParticle)を取得するためには、cellに含まれた無数のParticleを格納するBufferが必要になります。
// cid   0         1   2         3     4   5
cells = [[p0, p2], [], [p1, p5], [p4], [], [p3], ...]
cellsはgrid分割したcellの1次元配列で、cidはcell idです。
問題と解決
ここで問題があります。
このcellsは、Storage BufferとしてCompute Shaderで書きむことを想定していますが、GPUで扱うBufferはそのデータサイズをあらかじめ知っておく必要があります。
ひとつのcellにどれくらいParticleが入るのかは、Particleの位置によって決まりシミュレーションの時間経過で変化するため、不定になります。そのため、cellsのようなStorageBufferを直接作ることはできません。
そこで、以下のBufferを用意することでこの問題を解決していきます。
| buffer名 | 配列数 | 要素型 | 説明 |
|---|---|---|---|
| readParticles | particle | Data | particleのデータを格納した読み取り用の配列 |
| writeParticles | particle | Data | particleのデータを格納した書き込み用の配列 |
| particleCell | particle | u32 | particleが所属するcell idの配列 |
| cellCount | cell | u32 | cellに所属するparticleの数の配列 |
| cellStart | cell | u32 | cellに所属するparticleの開始位置の配列 |
| cellWriteCursor | cell | u32 | cellStartのコピー |
| cellParticleIndices | particle | u32 | cell id順に並べ替えたparticle idの配列 |
それぞれのStorage Bufferは要素のデータサイズがあらかじめわかるため、GPUで扱うことが可能です。
そして、最終的に以下のように参照します。
let cellId = i32(particleCell[pi]);

let cell = vec2i(
  cellId % grid.x,
  cellId / grid.x,
);

for (var x = -1; x <= 1; x++) {
  for (var y = -1; y <= 1; y++) {
    var nx = cell.x + x;
    var ny = cell.y + y;

    let neighborCellId = u32(ny * grid.x + nx);

    let start = cellStart[neighborCellId];
    let count = cellCount[neighborCellId];

    for (var i = 0u; i < count; i++) {
      let particleIndex = cellParticleIndices[start + i];

      if (particleIndex == pi) { continue; }

      let other = readParticles[particleIndex];
      let rVec = p.pos - other.pos;
      let rs = dot(rVec, rVec);

      if (rs < rMax * rMax) {
        // ...
      }
    }
  }
}
Bufferの作り方
各Bufferの意味を具体的に考えます。
例えば以下のように配置されたParticleを考えます。
赤点に振られた数字は、particle idです。
particleCell
particleが所属するcell idの配列
//       pid    0  1  2   3  4  5  6  7  8  9   10 11 12
particleCell = [7, 2, 10, 0, 5, 2, 7, 8, 6, 10, 0, 6, 7]
cellCount
cellに所属するParticleの数の配列
//    cid    0  1  2  3  4  5  6  7  8  9  10 11
cellCount = [2, 0, 2, 0, 0, 1, 2, 3, 1, 0, 2, 0]shaderではatomicAddを使用して加算をしていきます。
@group(0) @binding(0) var<storage, read> particleCell: array<u32>;
@group(0) @binding(1) var<storage, read_write> cellCount: array<atomic<u32>>;

@compute @workgroup_size(64)
fn cs(@builtin(global_invocation_id) gid3: vec3u) {
  let gid = gid3.x;
  if (gid >= arrayLength(&particleCell)) { return; }

  let cellId = particleCell[gid];
  atomicAdd(&cellCount[cellId], 1u);
}
cellStart
cellに所属するParticleの開始位置の配列
正確には次に作るcellParticleIndicesの開始位置を表します。
//    cid    0  1  2  3  4  5  6  7  8   9   10  11
cellStart = [0, 2, 2, 4, 4, 4, 5, 7, 10, 11, 11, 13]cellStartは、cellCountのprefix sumになります。
cellStart[0] = 0
cellStart[1] = cellCount[0] = 2
cellStart[2] = cellCount[0] + cellCount[1] = 2
cellStart[3] = cellCount[0] + cellCount[1] + cellCount[2] = 4
以下のように実装しましたが、よりGPUの特性を活かした「Blelloch scan」や「Hillis-Steele scan」という手法もあるようです。
@group(0) @binding(0) var<storage, read>       cellCount: array<u32>;
@group(0) @binding(1) var<storage, read_write> cellStart: array<u32>;

@compute @workgroup_size(64)
fn cs(@builtin(global_invocation_id) gid3: vec3u) {
  let gid = gid3.x;
  if (gid >= arrayLength(&cellCount)) { return; }

  var prefixSum = 0u;
  for(var i = 0u; i < arrayLength(&cellCount); i++) {
    if (i == gid) { break; }
    prefixSum += cellCount[i];
  }

  cellStart[gid] = prefixSum;
}
cellWriteCursor
cellStartのコピーで、cellParticleIndicesを作るのに使用します。
GPUCommandEncoder.copyBufferToBuffer(cellStart, cellWriteCursor)cellParticleIndices
cell id順に並べ替えたparticle idの配列
//              cid    0      2     5  6      7         8  10
cellParticleIndices = [3, 10, 1, 5, 4, 8, 11, 0, 6, 12, 7, 2, 9]
cellParticleIndicesは、cellStartをコピーしたcellWriteCursorから求められます。
@group(0) @binding(0) var<storage, read> particleCell: array<u32>;
@group(0) @binding(1) var<storage, read_write> cellWriteCursor: array<atomic<u32>>;
@group(0) @binding(2) var<storage, read_write> cellParticleIndices: array<u32>;

@compute @workgroup_size(64)
fn cs(@builtin(global_invocation_id) gid3: vec3u) {
  let gid = gid3.x;
  if (gid >= arrayLength(&particleCell)) { return; }

  let cellId = particleCell[gid];
  let offset = atomicAdd(&cellWriteCursor[cellId], 1u);

  cellParticleIndices[offset] = gid;
}
対応表は以下のようになります。
| cellParticleIndices | cellWriteCursor | cell id | particle id |
|---|---|---|---|
| 0 | 0 | 0 | 3 |
| 1 | 10 | ||
| 2 | 1 | ||
| 2 | 2 | 2 | 1 |
| 3 | 5 | ||
| 4 | 3 | ||
| 4 | 4 | ||
| 4 | 4 | 5 | 4 |
| 5 | 5 | 6 | 8 |
| 6 | 11 | ||
| 7 | 7 | 7 | 0 |
| 8 | 6 | ||
| 9 | 12 | ||
| 10 | 10 | 8 | 7 |
| 11 | 9 | ||
| 11 | 11 | 10 | 2 |
| 12 | 9 | ||
| 13 | 11 |
「要素同士の比較を行わずに、データの出現回数を数えて並び替える非比較ソートアルゴリズム」をCounting Sortと言います。
この考え方を使い今回のケースでは、cellに含まれるParticleの個数と、Particleを並べ替えたときのスタート位置を求めて、cell idを昇順並べ替えたときのparticle idの配列を作成しました。
Bufferの作成順序
以上のBufferの作成順序と、その時に参照されるBufferは以下の通りです。
| 順番 | 書き込み対象のBuffer | 参照されるBuffer |
|---|---|---|
| 1 | particleCell | readParticles |
| 2 | cellCount | particleCell |
| 3 | cellStart | cellCount |
| 4 | cellWriteCursor | cellStart |
| 5 | cellParticleIndices | particleCell cellWriteCursor |
| 6 | writeParticles | readParticles particleCell cellCount cellStart cellParticleIndices |
1フレーム目のreadParticlesには、ランダムサンプリング等で決められたデフォルト値が入ります。
6番は、シミュレーション本体の処理になります。
6番を終えた後に、writeParticlesとreadParticlesを入れ替えて前フレームのシミュレーション結果を次フレームのシミュレーションに伝えます。
終わりに
完全なコードは以下にあります。
GitHub | WebGPU Particle Life
github.com/spoon-inoue/webgpu-particle-life
環境にもよると思いますが、50,000個のParticleでも処理落ちせずに動作しました。
最適化できるとはいえ、シンプルなParticle LoopよりもBufferの数も多くなり、実装も手順を踏む必要があります。
なので、Particle量が比較的少ない場合はParticle Loopで、Particle量が多くなり最適化が必要な場合は今回のような最適化手法を用いるのが良さそうに思います。